记忆系统
该笔记是对于开源项目 ai-agent-book中第三章的内容的个人思考与总结笔记。
本章主线任务是回答Agent 应该记住什么、怎样存、怎样更新、怎样检索,以及如何判断记忆系统真的有用
与第二章的上下文管理不同,本章的记忆系统是一个长期的、跨会话的记忆系统,主要用于存储和检索 Agent 的长期记忆。如何让 Agent 在对话结束后仍然记住用户、记住知识。
持久化记忆体系
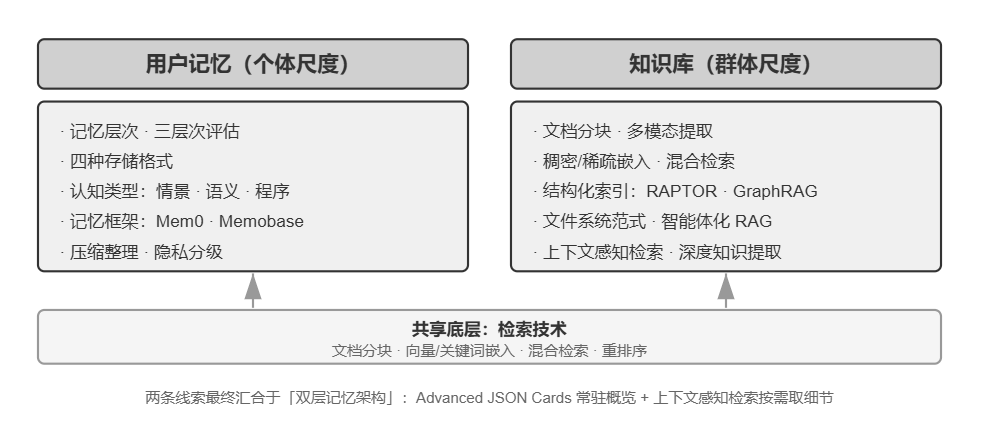
作者认为,持久化记忆体系可以分成两个部分:
一个是用户记忆,另一个是知识库。用户记忆是 Agent 对用户的偏好,信息的画像,是个体尺度
另一个是知识库,是某个领域的群体所共享的知识,是群体尺度,比如一个行业的法规体系、一家公司内部的操作流程、一个技术领域的专业文档
记忆能力的评估:三层次框架
第一层:基础回忆
第二层:多会话检索
第三层:主动服务
记忆系统的设计可以拆成三个独立的维度——放哪里、怎么存、存什么
| 分类体系 | 回答的问题 | 具体类别 |
|---|---|---|
| 记忆层次(本章开头) | 存在哪里? | 轨迹(当前会话)、用户长期记忆(跨会话)、业务状态(任务阶段) |
| 存储格式(“四种存储格式”一节) | 怎么存? | Simple Notes、Enhanced Notes、JSON Cards、Advanced JSON Cards |
| 认知类型(本节) | 存什么? | 情景记忆(具体事件)、语义记忆(一般知识)、程序记忆(行为流程) |
记忆压缩与整理机制
第一层通过重要性评分筛选。综合四个因素:访问频率(经常被检索的记忆更重要)、时间衰减(越久远的记忆越容易被遗忘)、情感强度(带有强烈情感标记的记忆更易保留)和信息独特性(重复信息的重要性降低)。
第二层通过聚类实现。
第三层是抽象和泛化——从具体情景记忆中提取一般性规律,转化为语义或程序记忆。
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 kjore's blog!